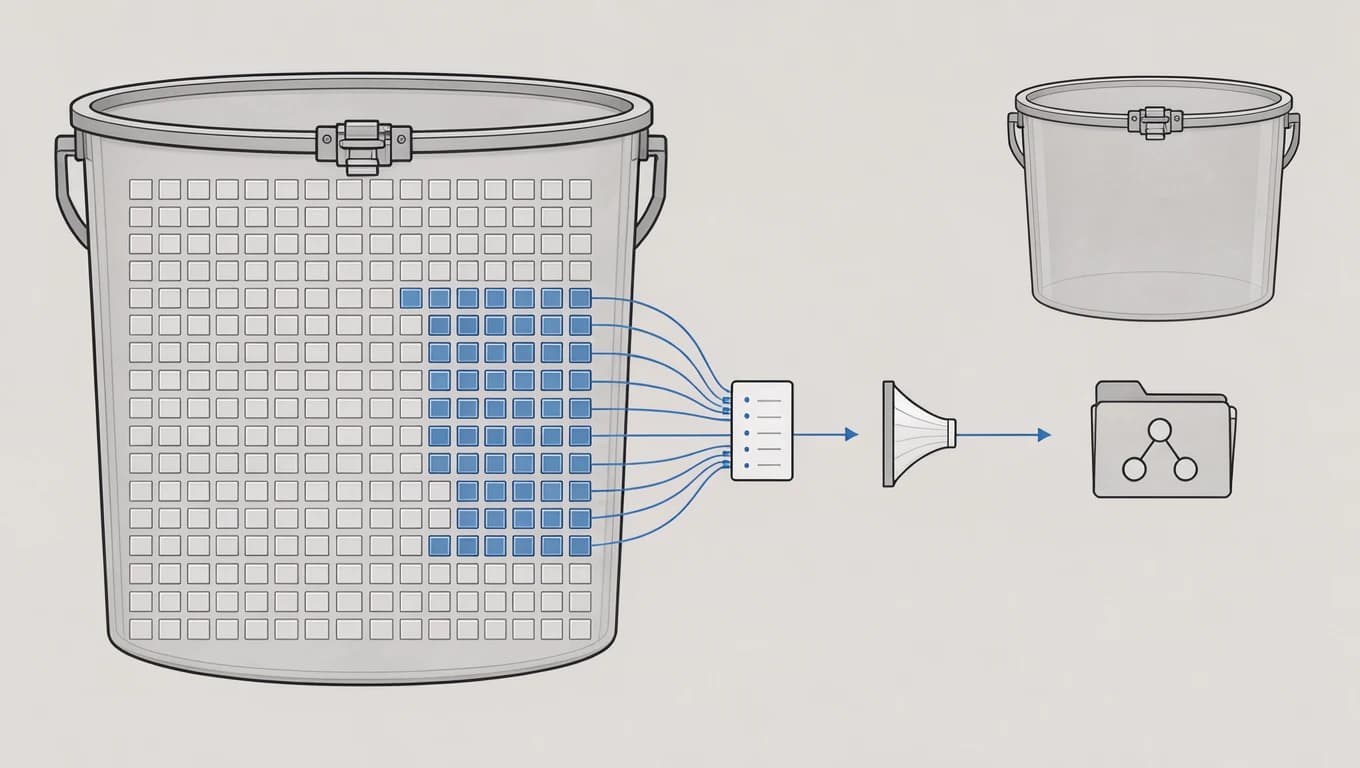
Me encuentro con una recuperación de emergencia utilizando Python, AWS CLI y PXAR, sin usar máquinas virtuales, ni instalar PBS.
El problema: mis servidores en casa, y yo en Sevilla
Tengo un cluster de Proxmox que ya he explicado en otro post (ENLAZAR), en él tengo mis servidores que uso en el día a día, mis webs y mis pruebas de cosas para casa. Nada serio pero que me jodería perderlo. Sobre todo mi git privado (Gitea)
Para los Backups de todo esto, uso Proxmox Backup Server (PBS) en un disco duro externo. El problema de esta infraestructura es que si mi casa arde o simplemente se cae internet y yo no estoy, pues estoy jodido. Así que tengo una segunda copia fuera de casa guardada en Hetzner Object Storage, mediante su integración nativa con S3.
El caso, es que la vida en el rural es así y una o dos veces al mes nos quedamos sin luz, sin internet o algo pasa. En esta ocasión me pilló fuera de casa y con ganas de trabajar de manera remota en uno de mis proyectos. Necesitaba en este caso, actualizar la pagina web de la empresa Quadrivium Tech.
La web la tenía por completo en mi gitea y necesitaba hacerlo ya. En concreto, necesitaba quadrivium-website.git.
Por lo general, ante una catastrofe, restauramos el contenedor LXC completo desde un Proxmox y andando, peroooo :
- Estaba con mi Mac del año de la pera y en él no me cabe un PBS
- Sin acceso al cluster de casa hasta dentro de unos días
Por contra, solo necesitaba un repositorio git, no toda la maquina.
SPOILER: La solución pasa por reconstruir el archivo de backup directamente desde los bloques almacenados en S3, enviarlo al programa PXAR y sacar de ahí únicamente el directorio que necesito.
1. Cómo almacena PBS los backups
Proxmox Backup Server no guarda las copias de los contenedores en un ZIP o TAR, mas quisiera ;)
Utiliza un almacenamiento deduplicado basado chunks.
En mi caso, el bucket de mi proveedor remoto Hetzner tenía esta estructura:
 RootBucket/
 └── HetznerBackupOffsite/
     ├── .cnt/
     │   ├── ct/
     │   ├── vm/
     │   └── host/
     └── .chunks/
Los metadatos e índices de los snapshots están en la carpeta .cnt, que además podemos ver que dentro contiene las maquinas virtuales, los contenedores y las maquinas completas, mientras que los bloques de datos se encuentran en la carpeta de los .chunks.
Cada snapshot LXC contiene archivos como los siguientes:
 catalog.pcat1.didx
 client.log.blob
 index.json.blob
 pct.conf.blob
 root.pxar.didx
Uno de los archivos más importante es root.pxar.didx, contiene el índice de bloques que permiten reconstruir el sistema de archivos del contenedor.
La estructura de este formato está documentada por Proxmox: ++PBS File Formats++.
2. Restauraremos todo en un Linux que tenía por aquí
La maquina es bastante simple, y al alcance de cualquiera, de hecho es una Ubuntu y no estoy demasiado acostumbrado a estas modernices (soy más de Debian o Slackware)
Lo primero es instalar las herramientas básicas:
$ sudo apt install -y awscli python3 zstd git curl
Después configuramos el acceso a los buckets de Hetzner, necesitaremos las credenciales como Access Key y la Secret Key.
$ aws configure --profile hetzner-recovery
Para una recuperación real, lo recomendable es emplear credenciales con permisos exclusivamente de lectura, pero las prisas me hicieron tirar palante.
Comprobamos la conexión:
$ aws --profile hetzner-recovery \
   --endpoint-url https://hel666.your-objectstorage.com \
   s3 ls s3://RootBucket/
Con esto vemos como está organizado el contenido remoto.
3. Buscamos el contenedor correcto
Puesto que no hay humano que recuerde (a pesar de verlo todos los días) el dichoso ID del contenedor hubo que listar todos los que estaban dentro de .cnt/ct
 .cnt/ct/101/
 .cnt/ct/102/
 .cnt/ct/120/
 ...
Dentro de cada snapshot se encuentra pct.conf.blob, está toda la configuración del contenedor, incluido normalmente el hostname y eso si que me lo se ;)
Descargando y decodificando esos pequeños archivos de configuración con Python, pude buscar el hostname git.
El resultado fue bueno: encontré el ID y a partir de ahora en mi sistema de gestión de inventario almaceno también el ID en Proxmox así no tengo que pasar de nuevo por aquí.
GIT ENCONTRADO: CT 120
Para repetir esta búsqueda, hay que listar los ID's mediante la linea de comandos de AWS, recuperar el pct.conf.blob más reciente de cada uno de ellos e interpretar la cabecera de su contenido. Los blobs son binarios sin cifrar (porque por suerte así lo tenía) pueden estar comprimidos con Zstandard. En cuanto identifiquemos el ID del contenedor, el resto de scripts ya solo trabajan sobre él. En mi caso, empleé el ultimo snapshot que tenía:
ct/120/2026-10-23T03:15:06Z
4. Recuperamos el índice del contenedor
Ahora descargamos el indice del snapshot:
 aws --profile hetzner-recovery \
   --endpoint-url https://hel666.your-objectstorage.com \
   s3api get-object \
   --bucket RootBucket \
   --key 'HetznerBackupOffsite/.cnt/ct/120/2026-10-23T04:35:06Z/root.pxar.didx' root.pxar.didx
Sorprendentemente, el archivo ocupa muy poco: 162 KB. Analizando las entradas del índice se obtuvo:
 Bloques referenciados: 3943
 Tamaño lógico PXAR: 14.75 GiB
En mi disco no me puedo permitir el lujo de tener 15GB libres, así que tenemos que ir al plan B, restaurar solo el repositorio que necesto.
La idea fundamental es reconstruir el PXAR como un flujo de datos y extraer selectivamente los archivos mientras se procesaba ese flujo.
5. Y localizamos el repositorio en el catálogo
PBS guarda también un catálogo de los archivos contenidos en el backup.
Descargamos catalog.pcat1.didx , reconstruimos catalog.pcat1 leyendo los bloques desde S3. El catálogo completo ocupa 1,77 MB.
Tenemos que localizar el repositorio, vamos a usar strings que es muy socorrido para analizar binarios::
strings -a catalog.pcat1 | grep -i quadrivium
Aquí está:
quadrivium-website.git
Después de revisar la estructura de directorios del catálogo, indentificamos la ruta completa:
/var/lib/gitea/data/gitea-repos/miusuario/quadrivium-website.git
Tenía todo lo necesario para intentar la restauración.
6. Descarga de PXAR sin instalar PBS
Como no queremos instalar un PBS desde cero (eso hubiera sido lo mas fácil) Necesitamos la aplicación pxar, Proxmox la distribuye como un paquete independiente proxmox-backup-client-static. Este es el enlace del fabricante : ++Proxmox Backup Client++
El paquete contiene dos ejecutables y alguna cosa mas, pero lo que nos interesa es esto:
 pxar
 proxmox-backup-client
Lo bueno es que no necesitamos instalar un servidor PBS, de hecho de eso se trata. Instalamos directamente ...
$ dpkg-deb -x pbs-client.deb pbs-tools
El programa pxar es la clave, entiende el formato de archivo de Proxmox y permite limitar qué directorios se extraen. Pero todavía nos falta algo. Darle los datos originales, desde S3.
7. El script de recuperación
Como lo que me suele apetecer es automatizar todo para no tener que repetirlo cuando me vuelva a suceder esto (que volverá a pasar), vamos a hacer un script que repita todo lo hecho a mano. Este script (como os imagináis me echó una mano Claude para hacerlo) lee las entradas del índice, descarga cada bloque desde el repositorio remoto, lo descomprime si es necesario, verifica su SHA-256 y lo envía a la salida estándar. Le he llamado stream-pxar.py :
 #!/usr/bin/env python3
"""Read-only Proxmox Backup Server dynamic-index archive streamer from S3.

Dependencies: Python 3, boto3, zstd CLI. Supports *unencrypted* PBS data chunks.
Outputs the reconstructed archive to stdout; pipe it to pxar extract.
No S3 write operations are used.
"""
import argparse
import hashlib
import os
import struct
import subprocess
import sys

RAW_MAGIC = bytes.fromhex('42ab3807be8370a1')
ZSTD_MAGIC = bytes.fromhex('31b958426fb6a37f')
DIDX_MAGIC = bytes.fromhex('1c914ea519bab3cd')
ENCRYPTED_MAGIC = {
    bytes.fromhex('7b6785be222d4cf0'),
    bytes.fromhex('e6591bbf0bbfd80b'),
}


def parse_args():
    p = argparse.ArgumentParser(description='Stream one unencrypted PBS PXAR archive from a read-only S3 datastore')
    p.add_argument('--endpoint', required=True, help='S3 endpoint URL (https://...)')
    p.add_argument('--bucket', required=True, help='S3 bucket name')
    p.add_argument('--datastore', required=True, help='S3 datastore object prefix, e.g. HetznerOffsite')
    p.add_argument('--ct', required=True, help='LXC container ID (number)')
    p.add_argument('--snapshot', required=True, help='Exact snapshot timestamp, e.g. 2026-10-23T04:35:06Z')
    p.add_argument('--archive', default='root.pxar.didx', help='Snapshot archive index filename')
    p.add_argument('--profile', default='default', help='AWS CLI credential profile')
    p.add_argument('--region', default='fsn1', help='S3 region name')
    p.add_argument('--path-style', action='store_true', help='Force S3 path-style bucket addressing')
    p.add_argument('--progress', type=int, default=100, help='Report every N chunks to stderr')
    return p.parse_args()


def eprint(*msg):
    print(*msg, file=sys.stderr, flush=True)


def main():
    args = parse_args()
    try:
        import boto3
        from botocore.config import Config
        from botocore.exceptions import BotoCoreError, ClientError
    except ImportError:
        eprint('Missing boto3. Install with: python3 -m pip install --user boto3')
        return 2

    prefix = args.datastore.strip('/')
    key = f'{prefix}/.cnt/ct/{args.ct}/{args.snapshot}/{args.archive}'
    session = boto3.Session(profile_name=args.profile, region_name=args.region)
    s3 = session.client('s3', endpoint_url=args.endpoint, config=Config(
        retries={'max_attempts': 5, 'mode': 'standard'},
        s3={'addressing_style': 'path' if args.path_style else 'auto'},
        max_pool_connections=5,
    ))
    eprint(f'Reading index s3://{args.bucket}/{key}')
    index = s3.get_object(Bucket=args.bucket, Key=key)['Body'].read()
    if len(index) < 4096 or index[:8] != DIDX_MAGIC:
        raise ValueError('Invalid dynamic PBS index (.didx)')
    entries = index[4096:]
    if not entries or len(entries) % 40 != 0:
        raise ValueError('Invalid or empty index entries')
    if hashlib.sha256(entries).digest() != index[32:64]:
        raise ValueError('DIDX SHA-256 checksum mismatch')

    total = len(entries) // 40
    eprint(f'Found {total} blocks; streaming PXAR to stdout')
    previous_end = 0
    for i in range(total):
        end = struct.unpack_from('<Q', entries, i * 40)[0]
        digest = entries[i * 40 + 8:i * 40 + 40]
        hexdigest = digest.hex()
        chunk_key = f'{prefix}/.chunks/{hexdigest[:4]}/{hexdigest}'
        chunk = s3.get_object(Bucket=args.bucket, Key=chunk_key)['Body'].read()
        magic, payload = chunk[:8], chunk[12:]
        if len(chunk) < 12:
            raise ValueError(f'Truncated block {hexdigest}')
        if magic == RAW_MAGIC:
            decoded = payload
        elif magic == ZSTD_MAGIC:
            decoded = subprocess.run(['zstd', '-dc'], input=payload,
                                     capture_output=True, check=True).stdout
        elif magic in ENCRYPTED_MAGIC:
            raise ValueError('Encrypted PBS chunks not supported; use your decryption key and official tooling')
        else:
            raise ValueError(f'Unknown chunk magic {magic.hex()} for {hexdigest}')
        if len(decoded) != end - previous_end:
            raise ValueError(f'Chunk size mismatch: {hexdigest}')
        if hashlib.sha256(decoded).digest() != digest:
            raise ValueError(f'Chunk SHA-256 mismatch: {hexdigest}')
        sys.stdout.buffer.write(decoded)
        previous_end = end
        if args.progress and (i + 1) % args.progress == 0:
            eprint(f'Processed {i + 1}/{total} chunks')
    sys.stdout.buffer.flush()
    eprint(f'Complete: {total}/{total} blocks, {previous_end} bytes')
    return 0


if __name__ == '__main__':
    try:
        sys.exit(main())
    except BrokenPipeError:
        eprint('Consumer closed the pipe; output archive incomplete')
        sys.exit(1)
    except Exception as ex:
        eprint(f'ERROR: {ex}')
        sys.exit(1)
Esta variante está pensada para bloques PBS no cifrados, como los que encontramos en mi instalación.
8. Ahora extraemos el repo buscado
Con el script preparado, ejecutamos:
set -o pipefail
python3 stream-pxar.py | \
/usr/bin/pxar extract - quadrivium-restored \
--pattern '/var/lib/gitea/data/gitea-repos/myuser/quadrivium-website.git/**' \
--no-acls true \
--no-xattrs true
La tubería hace que Python envíe directamente los datos reconstruidos al pxar. El proceso debe leer todos los bloques necesarios para recorrer el archivo, pero solo guarda los archivos que coinciden con el patrón indicado.
El ritmo fue un poco lamentable debido a las limitaciones de mi equipo, aproximadamente de unos 100 bloques cada dos minutos. Obviamente es mejorable (de hecho ya me lo sugirió el becario)
9. Comprobamos la integridad
Ahora comprobamos que lo que nos acabamos de traer es un repositorio Git y que todo está bien. Verificación simple:
$ git --git-dir="$REPO" rev-parse --is-bare-repository
$ true
Y comprobamos la integridad:
$ git --git-dir="$REPO" fsck --full
 Checking object directories: 100% (256/256), done.
 Checking objects: 100% (326/326), done.
Todo OK. Los 326 objetos Git superaron la verificación.
Finalmente, el repositorio podía clonarse desde otra máquina mediante SSH, o copiarse para trabajar localmente.
10. Podríamos haber aprendido mas ...
Gracias a la IA, he restaurado todo esto en un par de horas aproximadamente, el resultado es positivo porque puedo trabajar en lo que necesitaba de manera inmediata, pero sinceramente aprendía mas en el proceso antes de tener becarios.
La experiencia me dejó las siguientes conclusiones.
Primera: disponer de un backup remoto no debería significar depender de toda la infraestructura original para recuperar un archivo o una carpeta.
Segunda: los formatos abiertos y documentados son una ventaja increible. Sin la documentación de los índices de los chunks y de PXAR, esta recuperación habría sido imposible.
Tercera: no es necesario disponer de almacenamiento suficiente para restaurar todo un contenedor cuando podemos procesar los datos como un flujo y con tiempo.
Cuarta: las recuperaciones deben probarse antes de necesitarlas. Habría sido mucho más cómodo tener preparado este procedimiento.
Y, finalmente, conviene distinguir entre recuperar los datos de Git y recuperar el servidor completo Git: los repositorios contienen el código y su historial, pero no tengo ni incidencias, ni usuarios, ni nada. En este caso ha servido pero no siempre será util.
Conclusión
Empezamos con un contenedor de casi 15 GiB, almacenado en miles de bloques deduplicados en Hetzner, sin acceso a casa y sin una instancia operativa de Proxmox Backup Server.
Terminamos recuperando el repositorio que necesitábamos mediante una pequeña máquina Linux, unas herramientas CLI y un script Python.
Sin restaurar el LXC.
Sin instalar PBS Server.
Sin descargar el archivo PXAR completo al disco.
Y, especialmente importante, sin modificar ni un solo objeto del datastore remoto.
Las copias de seguridad son importantes. Pero saber recuperar exactamente lo que necesitas, incluso cuando todo lo demás falla, lo es todavía más.
Referencias técnicas: ++Proxmox Backup Server — File Formats++, ++Proxmox — Command Syntax++ y ++Hetzner — Using S3 Compatible CLI Tools++.