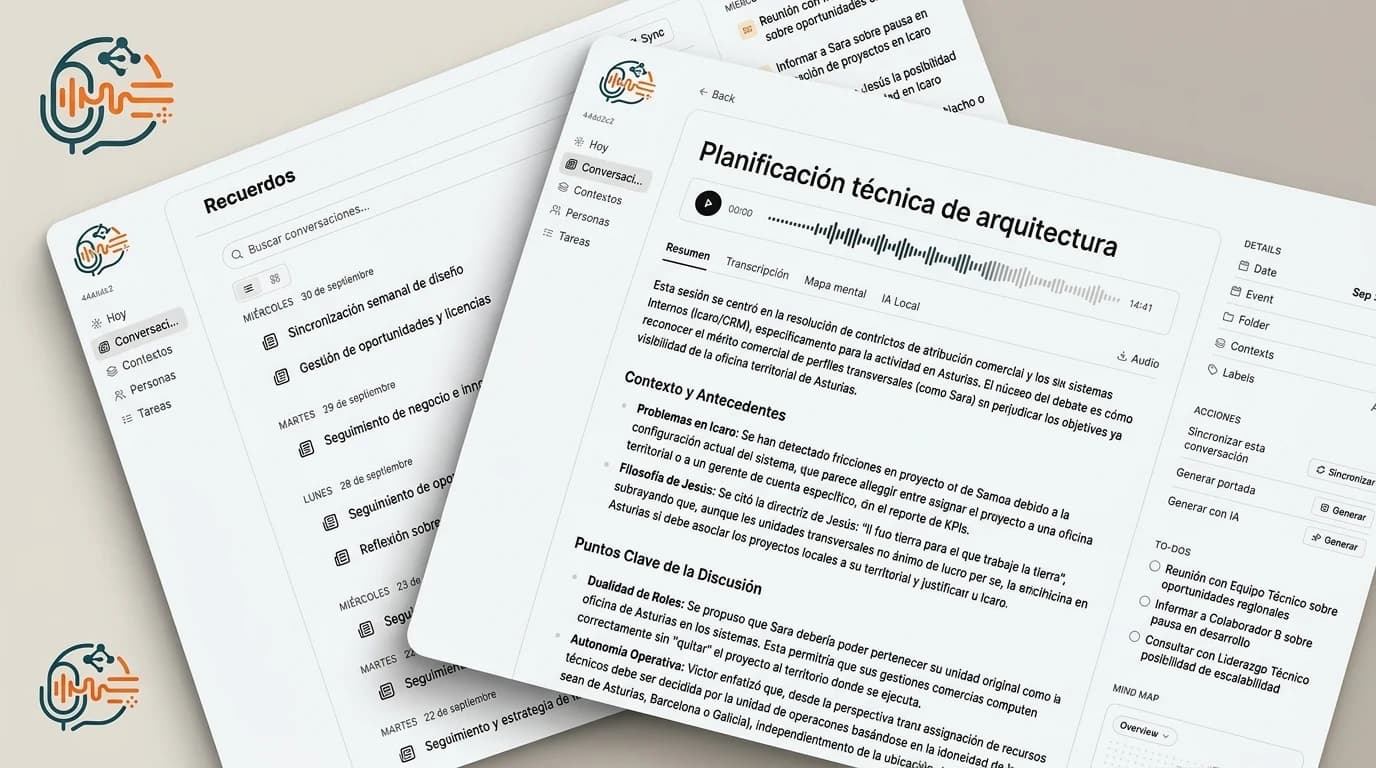
HeyPocket es una aplicación web personal y autoalojada. Su trabajo es archivar las conversaciones que graba mi grabadora Pocket —audio, transcripción con hablantes, resumen, mapa mental, tareas— y, sobre ese archivo, llevar el seguimiento de reuniones por proyecto con ayuda de modelos de lenguaje, solo cuando yo se lo pido.
Antes de seguir, el nombre. Pocket es una grabadora de voz comercial de otro fabricante, y el servicio de esa grabadora usa también el nombre «HeyPocket» (su API está en heypocketai.com). Este proyecto no tiene relación con ese fabricante ni con su servicio: es un cliente independiente que se conecta a mi cuenta mediante su API pública. Tampoco tiene relación con Pocket, el antiguo servicio de «leer más tarde» de Mozilla. Y la aplicación no graba: graba la grabadora.
De dónde salen las conversaciones
HeyPocket descarga de mi cuenta de Pocket, con mi propia clave, cada grabación y lo que el servicio genera a partir de ella: el audio original, la transcripción con hablantes, el resumen, el mapa mental, las tareas, las etiquetas y las carpetas. La sincronización se lanza cada quince minutos desde el cron del sistema; el audio se guarda en disco y el resto en PostgreSQL.
El audio se descarga una sola vez y se conserva, porque las URLs que da Pocket son firmadas y temporales. Si una conversación se borra en Pocket, aquí queda marcada como borrada, pero no se pierde. Todo lo que organizo —títulos, etiquetas, carpetas, archivado— vive solo en mi base de datos y no se escribe de vuelta en Pocket.
Por qué lo construí
Lo primero era tener los datos en casa. Quería una copia local completa y no depender de la aplicación web del fabricante para consultar mi propio histórico.
Lo segundo es que los resúmenes automáticos por reunión no me bastaban. Una reunión aislada se resume bien, pero seguir un proyecto necesita memoria entre reuniones: saber que la tarea que se pidió en la primera, por la que se preguntó en la segunda y que se entregó en la tercera es la misma cosa. De ahí salen los contextos y el reconciliador de memoria.
También quería controlar la IA. Ninguna llamada a un modelo se hace sola: ni al sincronizar, ni al abrir una página, ni por cron. Elijo proveedor y modelo para cada función, y cada llamada queda registrada con sus tokens, su petición y su respuesta. Cuando analizo una reunión, su texto viaja al proveedor que yo haya elegido; lo que controlo es cuándo se envía y con qué modelo.
Y quería comparar transcripciones. Ejecuto WhisperX en mis propios equipos, y la aplicación importa esa transcripción alternativa para ponerla junto a la de Pocket sobre el mismo audio.
Qué hace hoy
Captura y biblioteca
- Sincronización automática cada quince minutos y sincronización manual con un botón, con las conversaciones apareciendo en la lista según llegan.
- Detección de cambios: solo se vuelve a descargar lo que ha cambiado en Pocket.
- Búsqueda por el contenido de la transcripción, para encontrar una reunión por lo que se dijo.
- Filtros combinables por etiqueta, carpeta, idioma, fechas, duración y por si tiene transcripción, resumen o tareas.
- Vista de lista o de cuadrícula, agrupada por día, con portadas abstractas automáticas.
Detalle de una conversación
- Resumen enriquecido, con los gráficos, diagramas de flujo y líneas de tiempo que incluye el resumen de Pocket.
- Transcripción con reproducción sincronizada: se resalta el fragmento que suena y cada intervención tiene su botón de reproducir o pausar.
- Mapa mental navegable de los temas tratados, ampliable a pantalla completa.
- Asignación de hablantes a personas del directorio, una vez por hablante para toda la conversación, y una pestaña para cargar la transcripción alternativa de WhisperX con sus propios hablantes y tiempos.
- Descarga del audio en MP3 y exportación a Markdown.
Inteligencia de reuniones
Los contextos agrupan conversaciones por proyecto, cliente o departamento, con pestañas de resumen, conversaciones, acciones, oportunidades y decisiones. Sobre ellos funcionan tres acciones, todas manuales:
- Analizar con IA: extrae de una reunión acciones con responsable y fecha, oportunidades, decisiones, asuntos abiertos y riesgos, cada uno con su cita y su grado de confianza. Cada elemento se puede confirmar, editar o rechazar antes de que llegue a ninguna parte.
- Actualizar memoria del contexto: incorpora la reunión al estado del proyecto sin duplicar elementos, y guarda un histórico de eventos por elemento y una memoria ejecutiva versionada.
- Preparar próxima reunión: genera una agenda a partir del estado consolidado del contexto.
Aparte, la pantalla Hoy reúne lo vencido, lo bloqueado, mis acciones, las delegadas y las oportunidades abiertas; se calcula solo con SQL y reglas deterministas, sin IA. Y hay un directorio de personas con alias, para reconocer a la misma persona aunque aparezca con nombres distintos.
Cómo está hecho
TypeScript en todo el proyecto, sobre Node.js 22, en un monorepo con workspaces de npm. El frontal es React 18 con Vite, Tailwind CSS, React Router y Recharts para los gráficos del resumen; es una PWA instalable. El servidor es Fastify 5, con sesión por cookie, contraseñas cifradas con argon2 y Zod para validar. La base de datos es PostgreSQL con Prisma, y el audio y las portadas se guardan en disco, fuera de la base.
Para los textos uso OpenAI o DeepSeek, con una capa común compatible con la API de OpenAI; la portada con IA usa el modelo de imagen de OpenAI. WhisperX no corre dentro de la aplicación: la transcripción alternativa la genero fuera y la aplicación solo la importa.
El despliegue es una máquina virtual Debian en mi propio servidor, con un único proceso Node gestionado con pm2 que sirve la API y el frontal compilado, detrás de un proxy inverso con HTTPS. Hay unos 55 tests de integración contra una base de datos separada; las llamadas a los proveedores de IA se simulan, así que los tests nunca contactan con OpenAI ni con DeepSeek.
Decisiones que me parecen interesantes
- Cron del sistema en lugar de un planificador propio. La sincronización es un script que invoca el crontab; la zona horaria, los reintentos y los registros quedan en manos del sistema operativo.
- Bloqueo de sincronización en PostgreSQL. Dos sincronizaciones no pueden solaparse porque el bloqueo vive en una tabla y no en memoria, así que protege igual al cron que al botón manual aunque sean procesos distintos.
- Sincronización incremental con ventana de seguridad. Solo revisa los últimos días, salta lo que no ha cambiado y no vuelve a descargar transcripciones ni resúmenes.
- IA bajo demanda y sin modelo por defecto. Si una función no tiene proveedor y modelo configurados, no se ejecuta. El registro de llamadas guarda proveedor, modelo, tokens, duración, petición y respuesta, y todo lo que se escribe pasa antes por un filtro que elimina cualquier fragmento de clave.
- Un esquema, dos usos. Los esquemas de salida se escriben una vez con Zod: sirven para validar la respuesta del modelo y para generar el JSON Schema que se envía al proveedor. Cada resultado guarda la clave y la versión del prompt que lo produjo.
- Las citas se comprueban contra la transcripción. Cada elemento extraído lleva una cita y un momento de la reunión; el servidor la busca en la transcripción real y la marca como exacta, aproximada o no verificada. La cita nunca se reescribe: si no aparece, se conserva señalada.
- Referencias cortas para el modelo. Al reconciliar la memoria, el estado del contexto se envía con referencias tipo A1, O2, D3, T4, y el modelo responde con eventos sobre esas referencias (creada, mencionada, completada) en vez de reescribir el estado entero.
- La transcripción de WhisperX se procesa en el navegador: envía solo hablante, tiempos y texto de cada segmento. En un caso real, un archivo de 460 KB quedó en unos 25 KB.
- Portadas baratas. Por defecto cada conversación tiene una portada abstracta generada en el navegador a partir de su identificador, siempre la misma para la misma grabación y sin llamar a ninguna API. La de IA es opcional, usa la calidad más baja del modelo porque solo se ve como miniatura, y elige una paleta pastel distinta para cada grabación.
- El mapa mental se dibuja con un componente SVG propio: un diagrama de izquierda a derecha, con una columna por nivel y un color por rama.
Estado
Es un proyecto personal en desarrollo activo, con una sola cuenta (la mía) y sin registro público. El primer commit es del 17 de septiembre de 2026 y ese mismo día ya había una versión desplegada en mi servidor. A 30 de septiembre de 2026 son unas dos semanas de trabajo, 37 commits y 16 migraciones de base de datos. Poco a poco: el 18 de septiembre llegaron las portadas con IA y los resúmenes con gráficos; el 22, la interfaz móvil y el logotipo; el 28, las carpetas; y el 30, toda la capa de inteligencia de reuniones, la descarga de audio y la transcripción local.
Hay dos cosas previstas: una ruta para preguntar al archivo con IA, todavía sin implementar, y el soporte de varias cuentas, que el modelo de datos admite pero que hoy no existe.