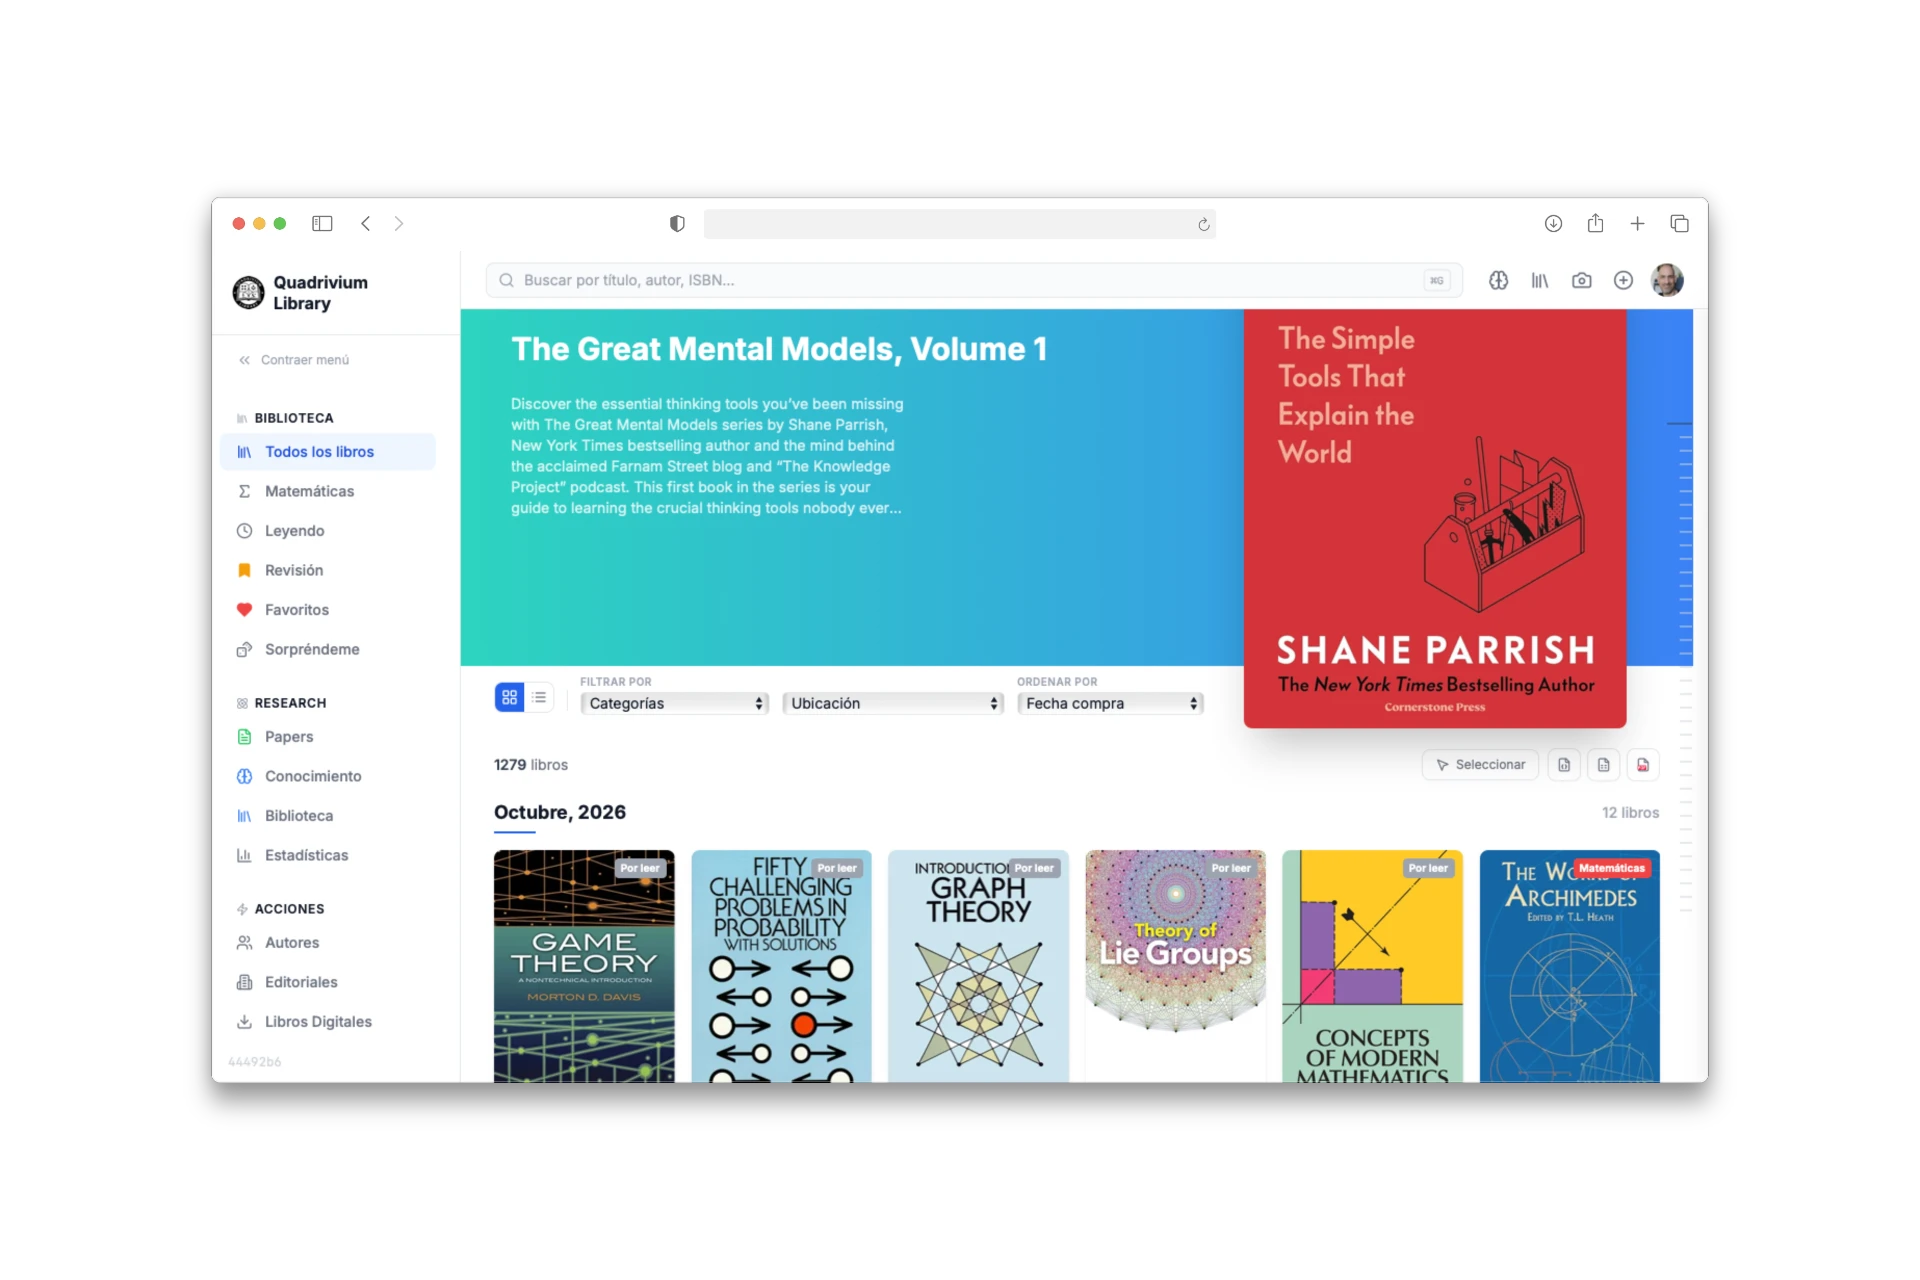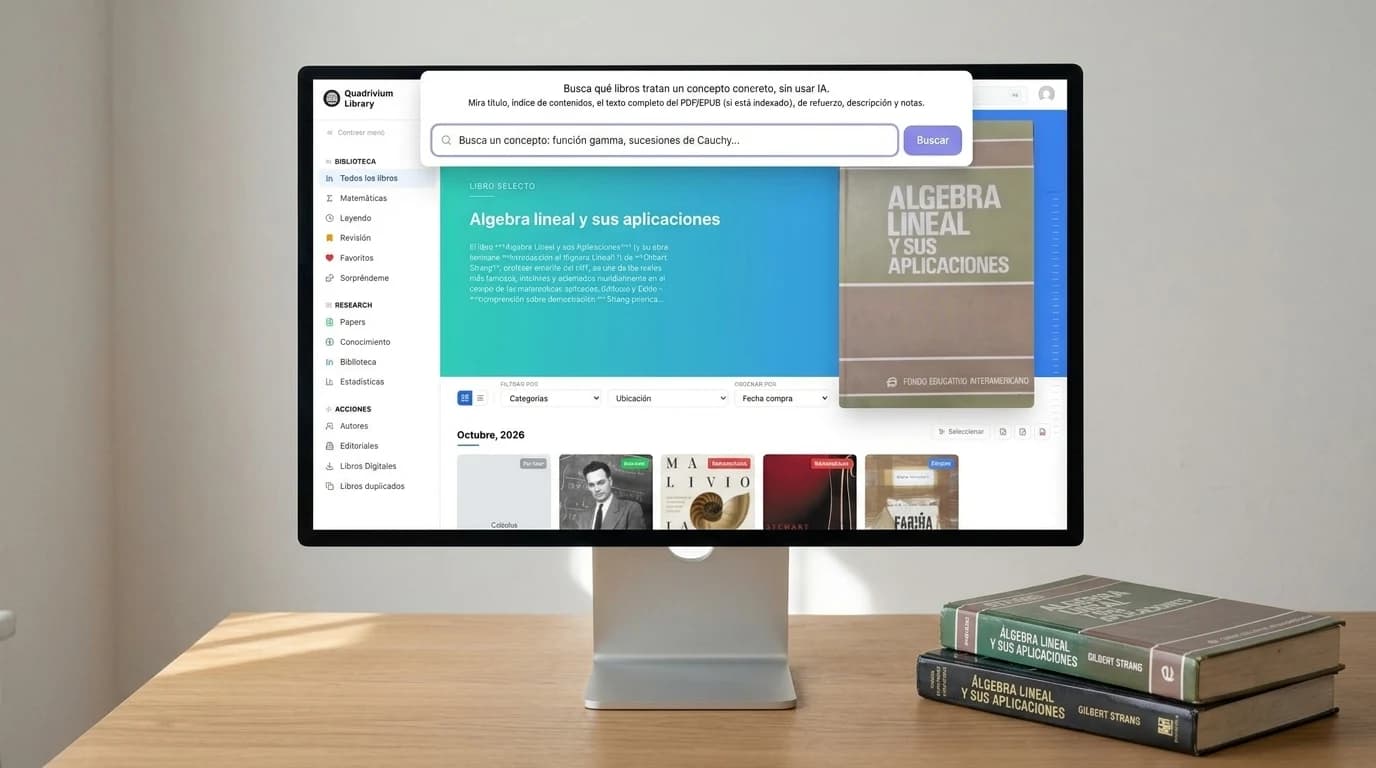
Quadrivium Library es mi biblioteca personal, pero no solo eso, es en realidad una herramienta de aprendizaje. En principio empezó con dos preguntas que he hacía a diario: Este libro tan interesante ya lo tengo ? y en caso que lo tenga ... donde está ? con más de mil libros, entre los que hay muchos de matemáticas y ciencias, no es algo trivial. Además de saber que tengo también quiero saber que hay en ellos, es decir ... tengo muchos de Álgebra pero casi ninguno de teoría de juegos.
Una biblioteca tradicional guarda títulos, autores, categorías y poco mas, pero eso no es suficiente. En la aplicación intento que la biblioteca sea un único lugar, donde se integra el catálogo, el progreso de la lectura, la ubicación física y el índice o contenido de los libros, esto es especialmente útil para los libros técnicos aunque recientemente también lo uso para el resto de libros.
De dónde viene
Antes de crear esta aplicación, la información estaba dispersa. Excel al principio, Notion después, los propios libros y notas en las aplicaciones de tareas, e incluso de memoria. Por ejemplo, sabía que tenía un libro, pero no donde estaba, o incluso si era el adecuado para el tema que quería aprender esa semana. En la aplicación Quadrivium Library intento integrarlo todo en un único sistema que permita consultar todo de diferentes maneras: por un lado como una simple colección de libros físicos, per también como un mapa de conceptos que permita establecer la base para planificar aprendizajes.
Qué hace a día de hoy
Biblioteca
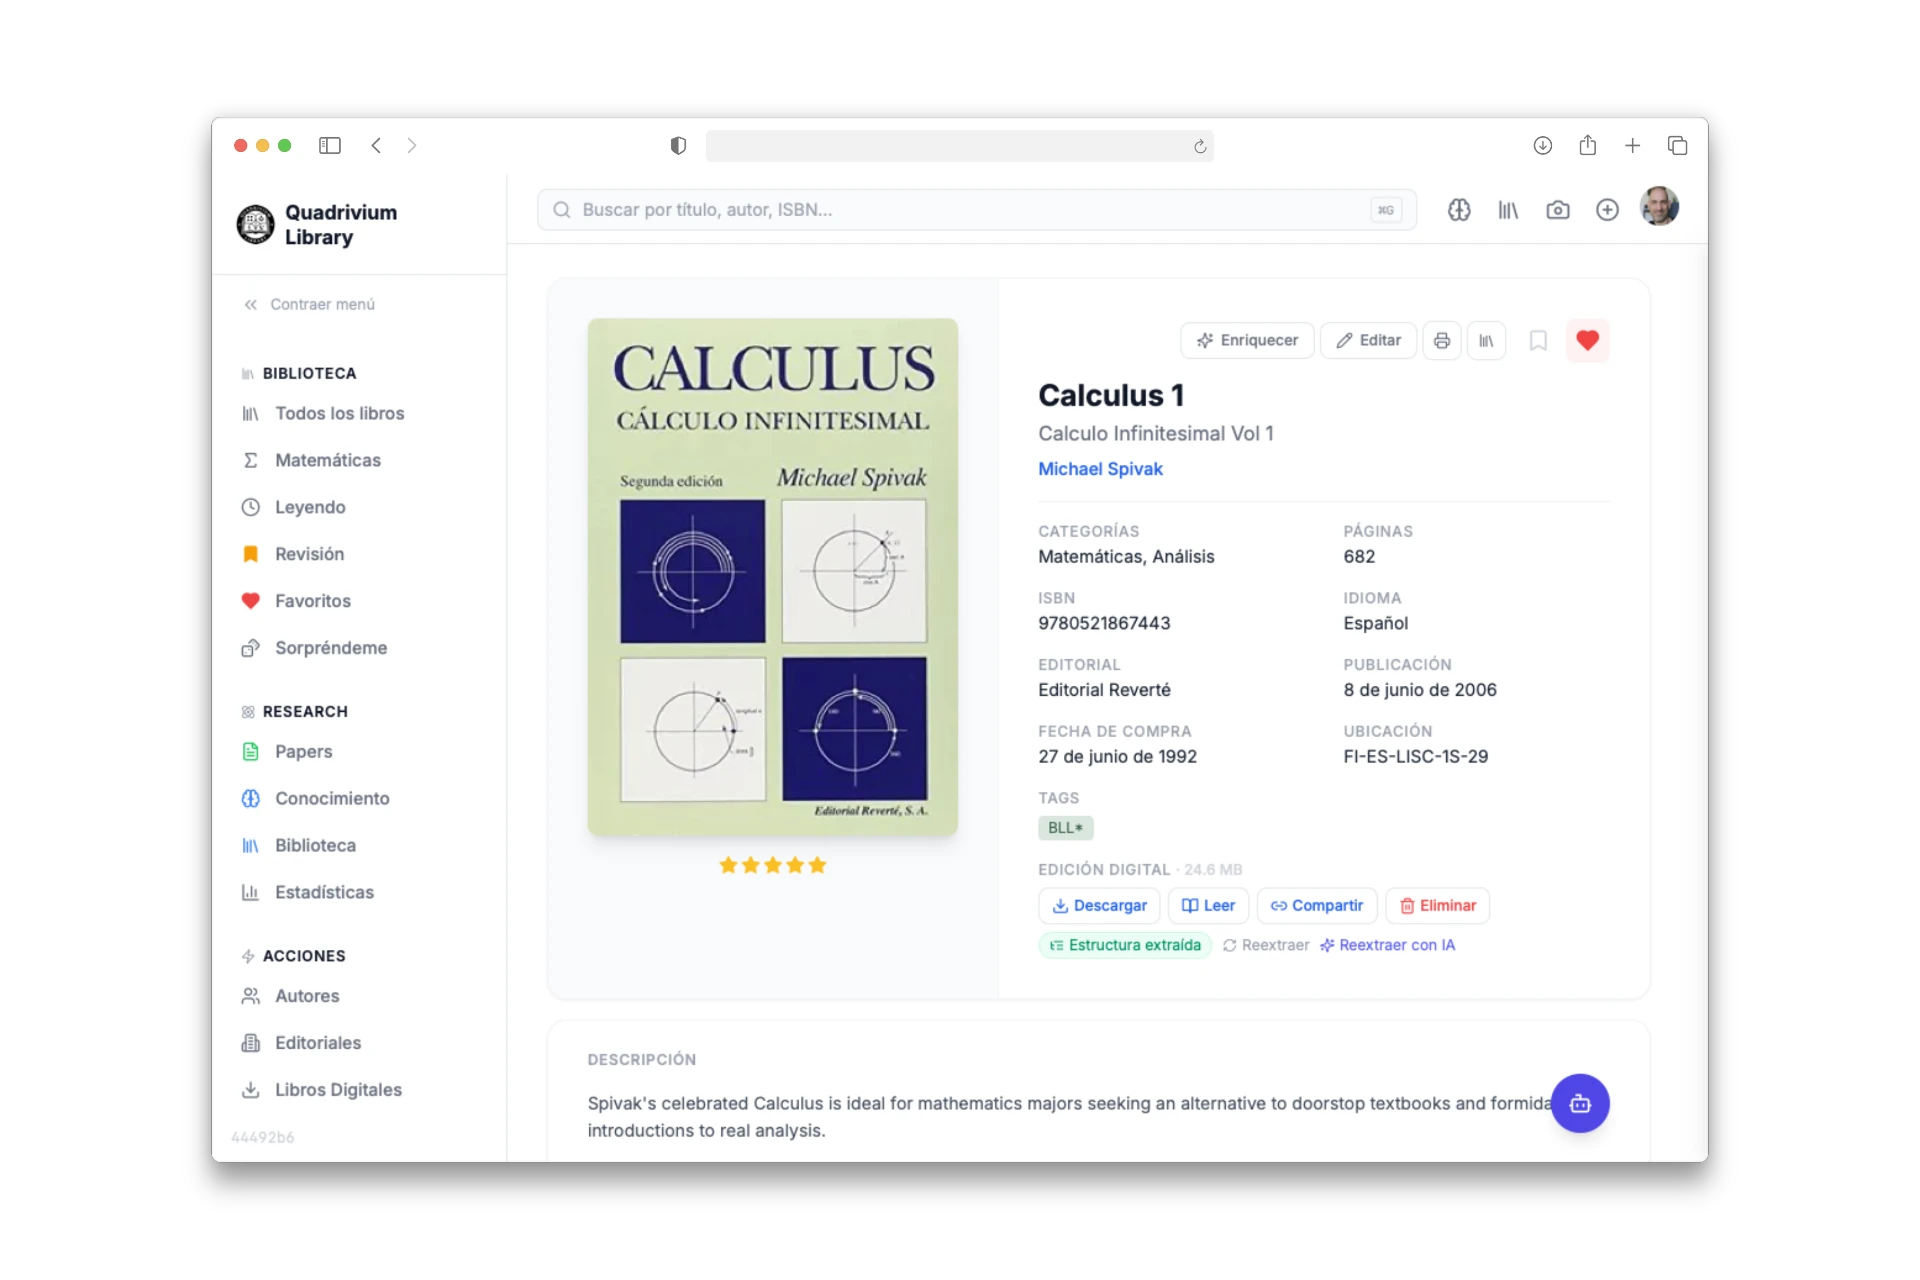
Mantiene un catálogo de los libros. En él aparecen título, subtítulo, autores, categorías, editorial, ISBN, idioma, páginas, fechas, descripción, etiquetas y portada. Se pueden añadir libros de manera manual o importando desde las exportaciones de Notion (aunque esto solo se emplea para la carga inicial). También se pueden completar los metadatos consultando en fuentes externas (Google Books, Open Library...) y yo creo que esta es una de las partes mas importantes de la biblioteca, porque es habitual comprar un libro y no registrarlo por la pereza que da introducir los metadatos. El sistema se ha ido refinando hasta el punto que se puede sacar una foto a la portada y se cataloga el libro "casi" a la perfección empleando una mezcla de flujos con n8n, IA y varias APIs.
flowchart LR
    subgraph CAPTURA["1 · Captura"]
        direction TB
        A["📱 Aplicación móvil"]
        B["📨 Webhook n8n"]
        C["🖼️ Preparar imagen"]
        A --> B --> C
    end

    subgraph ANALISIS["2 · Análisis y enriquecimiento"]
        direction TB
        D["🤖 Reconocimiento IA"]
        E["📚 Google Books + Open Library"]
        D --> E
    end

    subgraph CATALOGO["3 · Catalogación"]
        direction TB
        F["🧩 Consolidar metadatos"]
        G["📡 API Books2Smartppl"]
        H["📖 Libro catalogado"]
        F --> G --> H
    end

    C --> D
    E --> F

    classDef entrada fill:#dbeafe,stroke:#2563eb,color:#1e40af
    classDef ia fill:#ede9fe,stroke:#7c3aed,color:#5b21b6
    classDef proceso fill:#f1f5f9,stroke:#64748b,color:#334155
    classDef final fill:#dcfce7,stroke:#16a34a,color:#166534

    class A,B,C entrada
    class D,E ia
    class F,G proceso
    class H final
La ficha de libro permite modificar los datos principales. Desde ella también se pueden realizar búsquedas y filtros (texto, categoría, autor, editorial, estado de lectura, ubicación, favorito, edición digitaldisponible). Se pueden ordenar por fechas, título, autor, ubicación. Hay algunas vistas predefinidas para las preguntas recurrentes (sin ubicación, sin portada, sin categoría, sin fecha, técnicos, de estudio...).
Hay gráficas ... como me encantan las gráficas ;) En ellas se muestran las distribuciones por categoría.
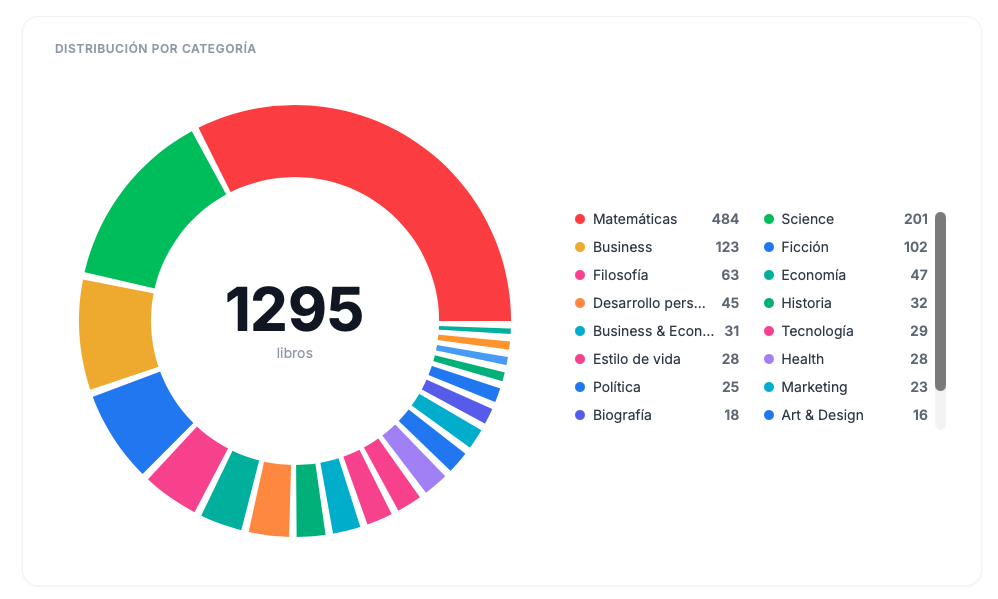
También se pueden ver las distribuciones por año de adquisición. Se pueden agrupar por autor o editorial. Hay un detector de posibles duplicados (incorporación muy reciente).
Notas y relaciones entre libros
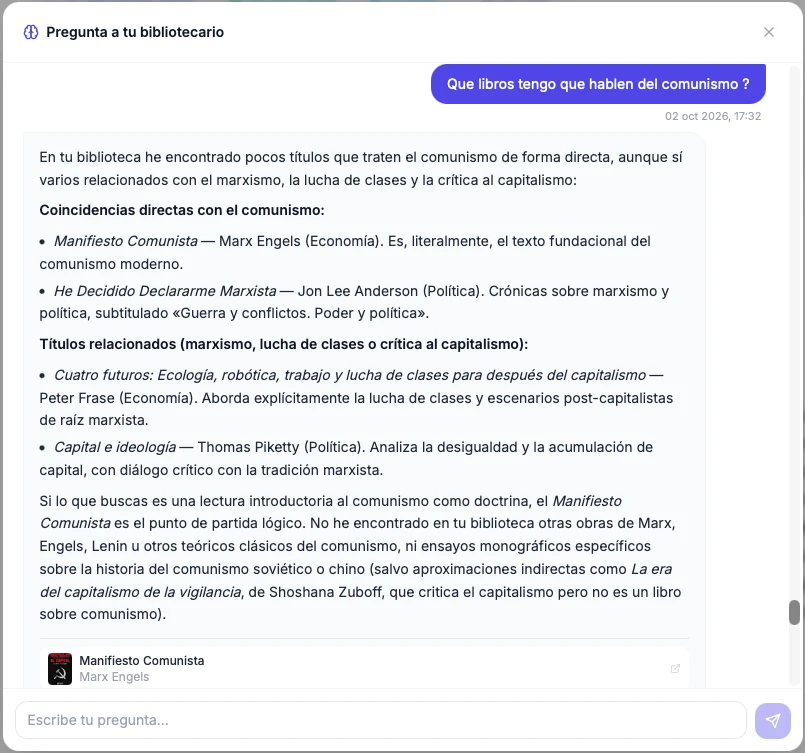
Se pueden añadir notas generales, resúmenes, notas de capítulo, ejercicios, citas e ideas. También puedo registrar relaciones entre libros —prerrequisito, complemento, mayor o menor dificultad, mismo tema, misma colección, sustitución. Esto es especialmente importante para poder establecer rutas de aprendizaje en el futuro.
Y por lo tanto se pueden hacer preguntas sobre el catálogo con "1,2,3 Pregunta a tu bibliotecario", que devuelve una respuesta junto a los libros relacionados.
Ubicación física
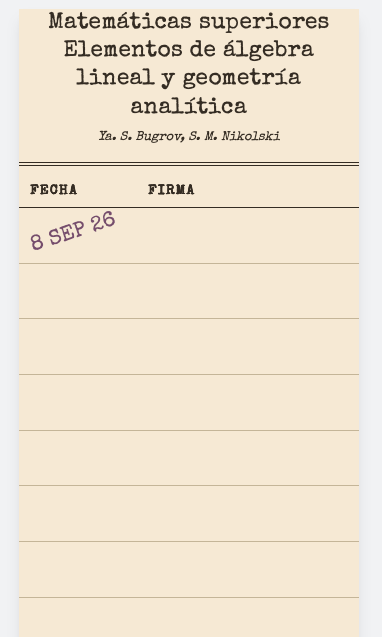
Se definen ubicaciones jerárquicas (casa, habitaciones, librerías, estanterías, baldas, cajas, frutero, ...) . Los libros se mueven entre baldas arrastrándolos a su nuevo sitio. Se mantiene la posición relativa del libro de modo que me cuesta menos trabajo localizar un libro. Además una nueva incorporación es la generación de tarjetas de libros con un formato similar a los de los prestamos de las bibliotecas. Existe además un flujo para reconocer libros a partir de imágenes de estanterías y proponer ubicaciones.
No se aprecia en la imagen, pero al final de todo aparece la ubicación exacta del libro, de modo que cuando se acaba de consultar el libro, se puede devolver a donde debe estar.
Ediciones digitales y documentos
Otra necesidad que quizás no aporte demasiado pero que ha sido muy facil de implementar es el adjuntar ediciones digitales en PDF o EPUB. Aquellas que son compatibles se pueden abrir desde dentro de la aplicación. Se extrae la estructura automáticamente y aprovechamos índices, introducciones, bibliografías, etc ... para poder aumentar la información de cada libro. Los PDF se leen con PDF.js buscando texto nativo y marcadores; los EPUB se leen a partir de estructuras como nav.xhtml o toc.ncx. Si hay algún error en la extracción, siempre se puede lanzar de nuevo a mano o picar el indice en el campo adecuado. Los PDF que están escaneados (no tienen capa de texto) no se procesan con el OCR sino que se marcan como no aplicables.
Mapa de conocimiento
Conceptos. Itinerarios. Atlas.
Clasificación matemática. Esta sección es probablemente la mas importante, pues de una buena clasificación proviene un buen sistema de itinerario y planificación. Tenemos una taxonomía que define las áreas, subáreas y temas. Es una taxonomía cerrada obtenida de fuentes oficiales que ahora mismo no recuerdo. Se puede consultar y añadir el tema ó área principal del libro, su nivel estimado (Universitario, Especializado, etc ...), el tipo de uso del libro (ejercicios, estudio, investigación, referencia) y los temas cubiertos. Hay una cola de Revisión mediante IA donde se muestran las clasificaciones propuestas y se puede gestionar manualmente cada una de ellas o analizarla con otro modelo. En esta vista, además podemos ver las áreas fuertes y débiles de la biblioteca, revisando así los temas que no tengo cubiertos.
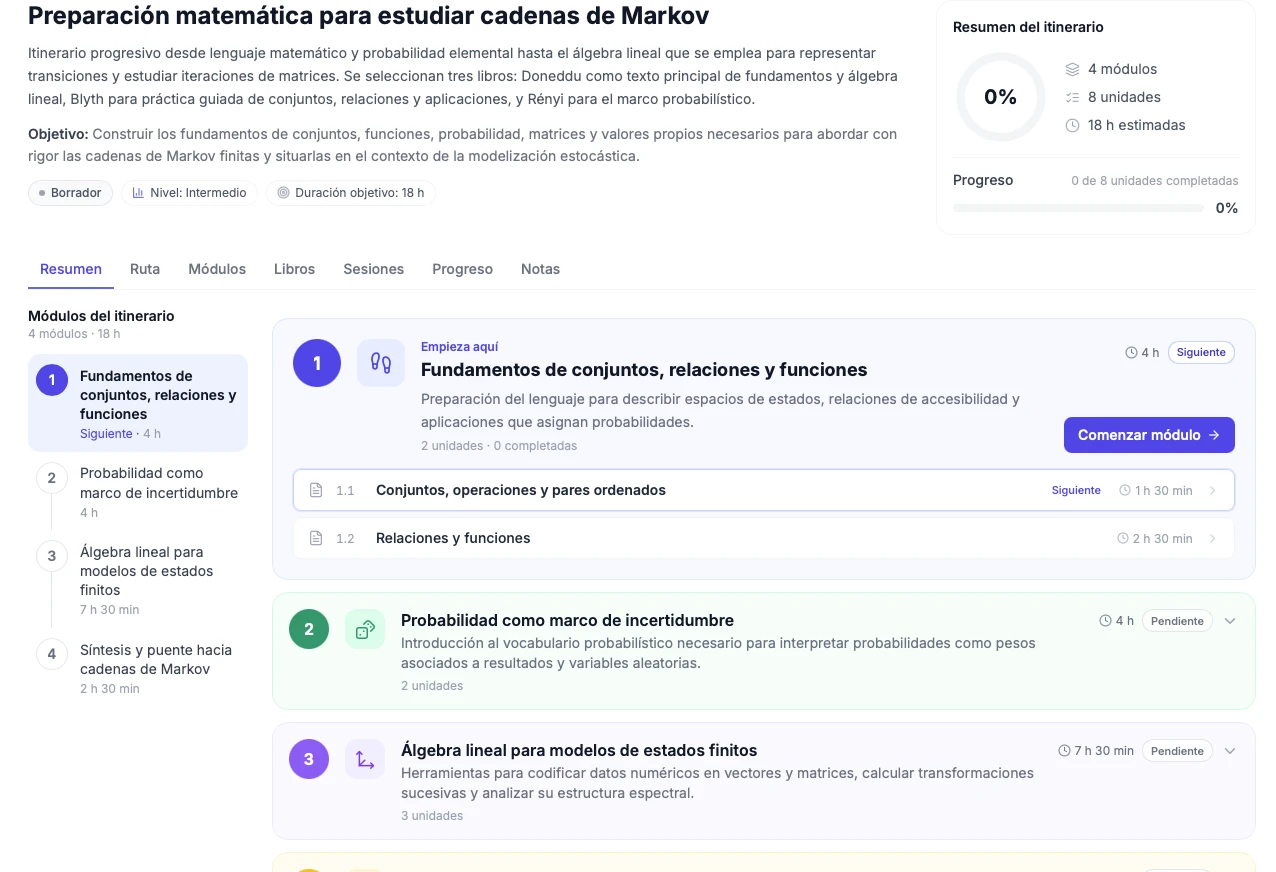
Los itinerarios de estudio fueron una de las primeras puntas de lanza para introducir el concepto de librería inteligente. Un itinerario sería algo así como la ruta necesaria para poder comprender un tema en particular. Se pueden crear itenerarios a partir de un simple prompt o se pueden crear itinerarios a mano. Al finalizar el itinerario tendremos una ruta completa de aprendizaje, paso a paso y si tenemos los libros correctamente clasificados, incluso podemos anotar que paginas de que libro y en que orden deberíamos ir estudiando. El proceso sería algo así: Primero se prepara un prompt adecuado a lo que queremos investigar, aprender o conocer mejor y se lo pasamos al sistema. La IA genera un plan conceptual (fundamentos, núcleo, ampliaciones y dependencias). Luego se valida este plan contra la taxonomía real (se comprueba que no haya cosas raras, conceptos desconocidos y que cubra el objetivo que perseguiamos). Luego buscamos localmente los libros y apartados necesarios para comprender el objetivo. A continuación se vuelve a llamar a la IA para generar el plan de módulos, unidades, lecturas, ejercicios y criterios de éxito. Finalmente se guarda en vista previa. Hay que confirmar explícitamente para que sea itinerario.
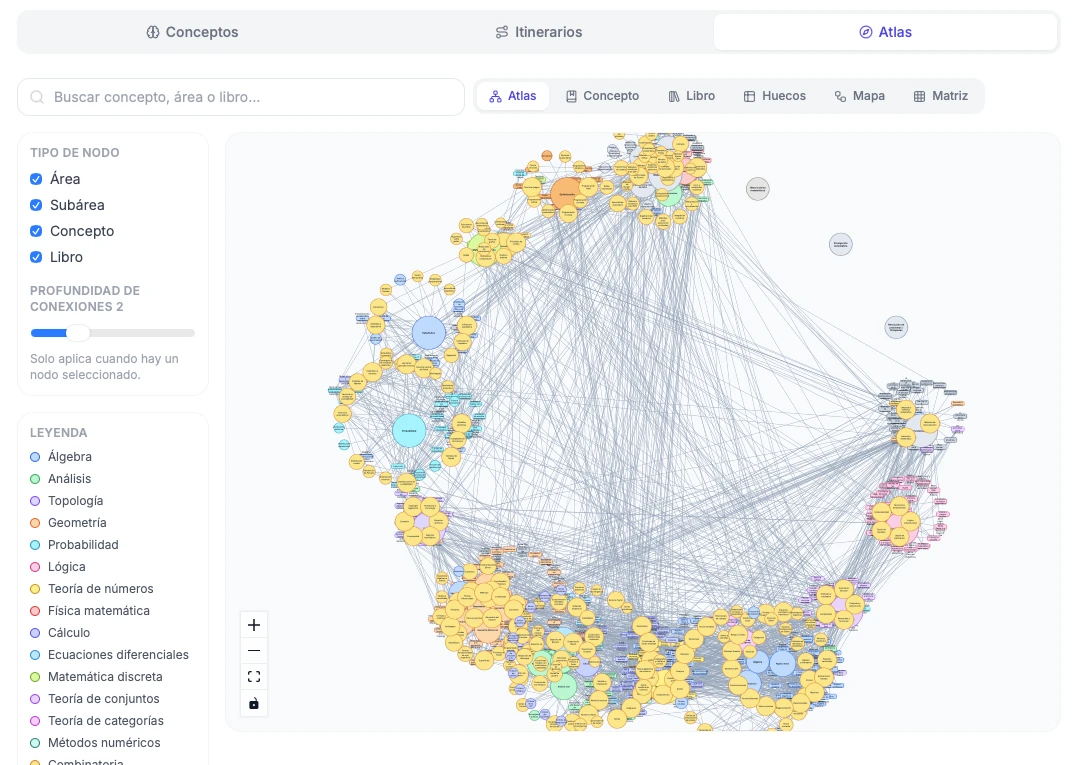
En el Atlas se muestran las áreas, las subáreas y los libros en un grafo 2D interactivo. Es algo que claramente hay que mejorar porque al tener tanta información el sistema se vuelve inmanejable y lo he dejado de usar prácticamente. Estaba pensado como una herramienta de exploración y revisión. No como una enciclopedia o taxonomía validada por expertos.
El buscador de conceptos surge como una respuesta rápida a conceptos simples que ya tienen una entidad propia y solo queremos localizarlos a lo largo y ancho de la biblioteca. No utilizamos embeddings ni pgvector. Todo se basa en texto normalizado para poder reducir las llamadas a los modelos de IA. Utilizamos los índices de PostgreSQL (con los contenidos, las descripciones y las notas extraídas de los libros). Es posible ver de dónde vienen las coincidencias, las evidencias nos sirven para saber de donde ha sacado la IA las conclusiones a las que ha llegado. Sin embargo, no es un entendimiento semántico completo. Es una coincidencia de texto. Es una evidencia de que cubre bien el tema.
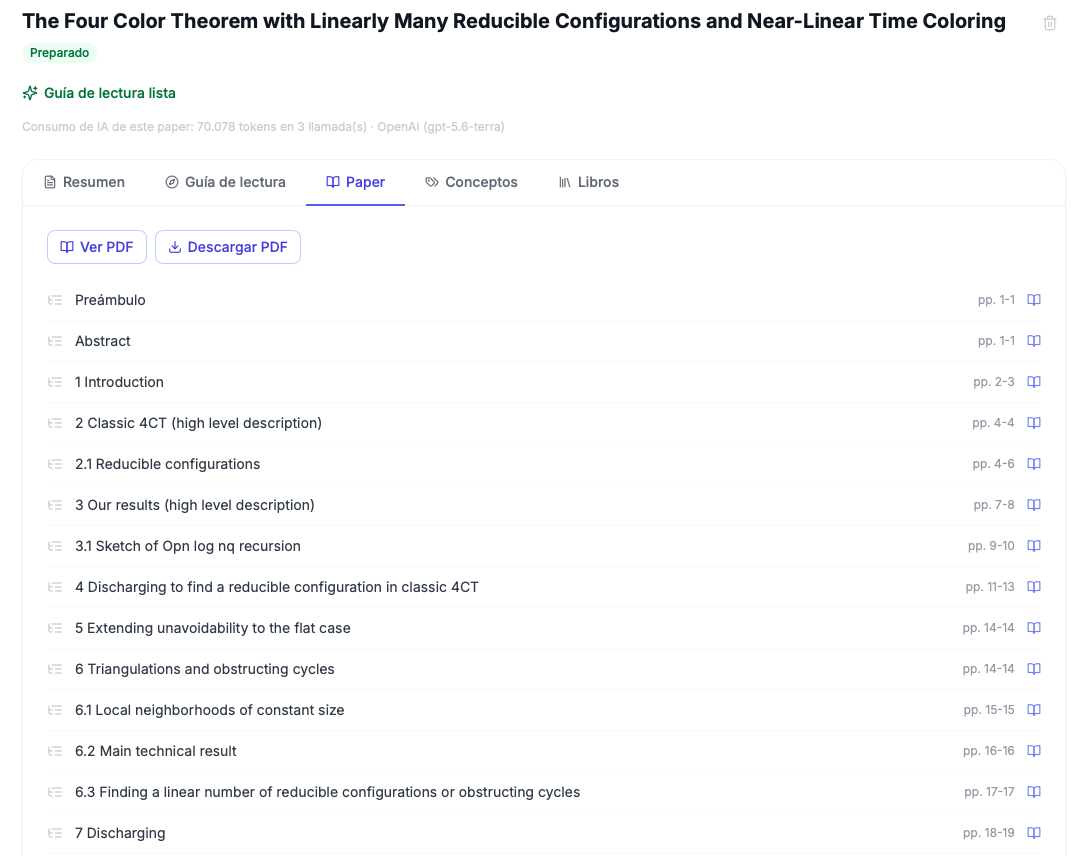
Papers
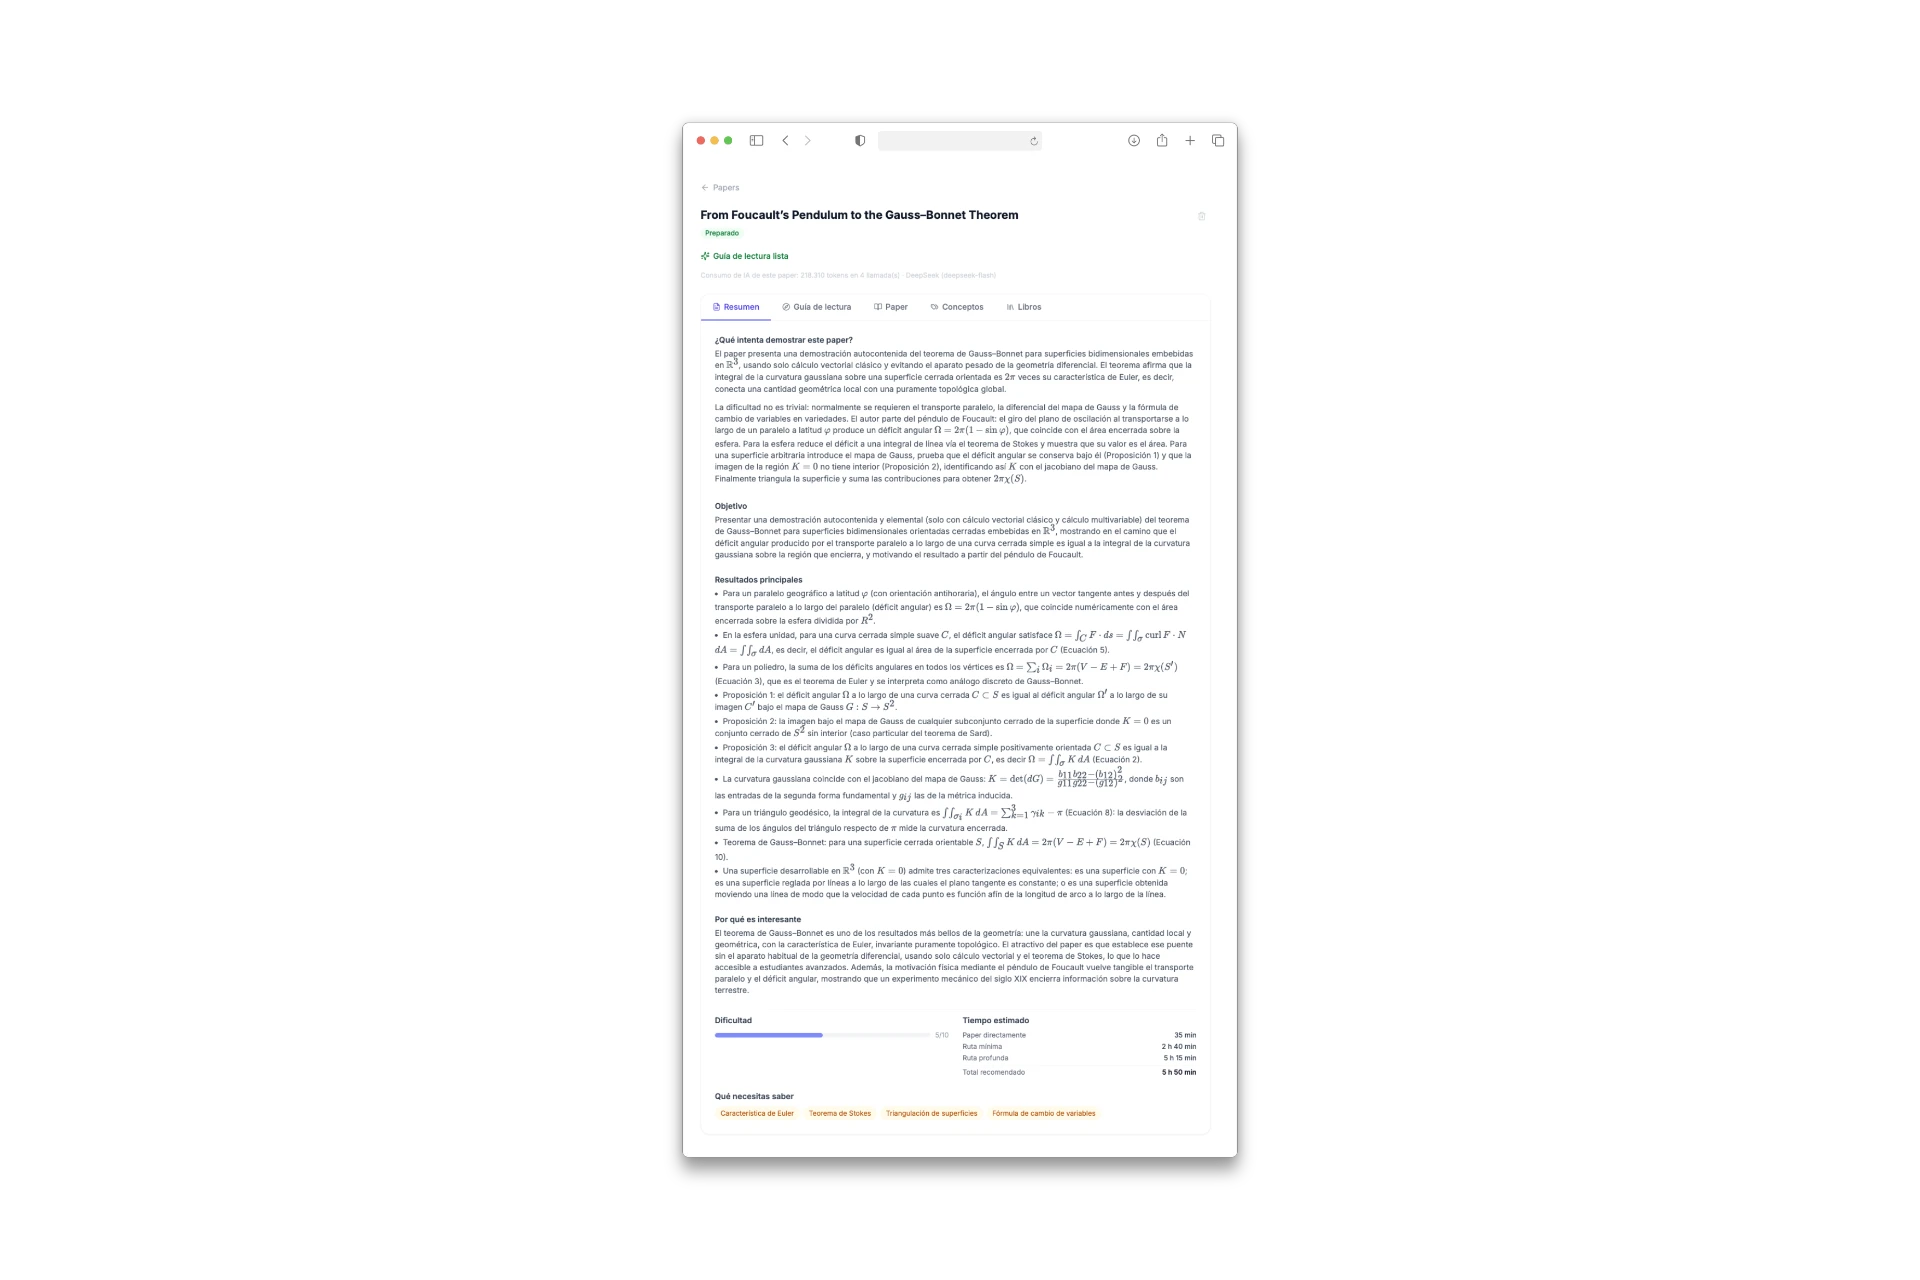
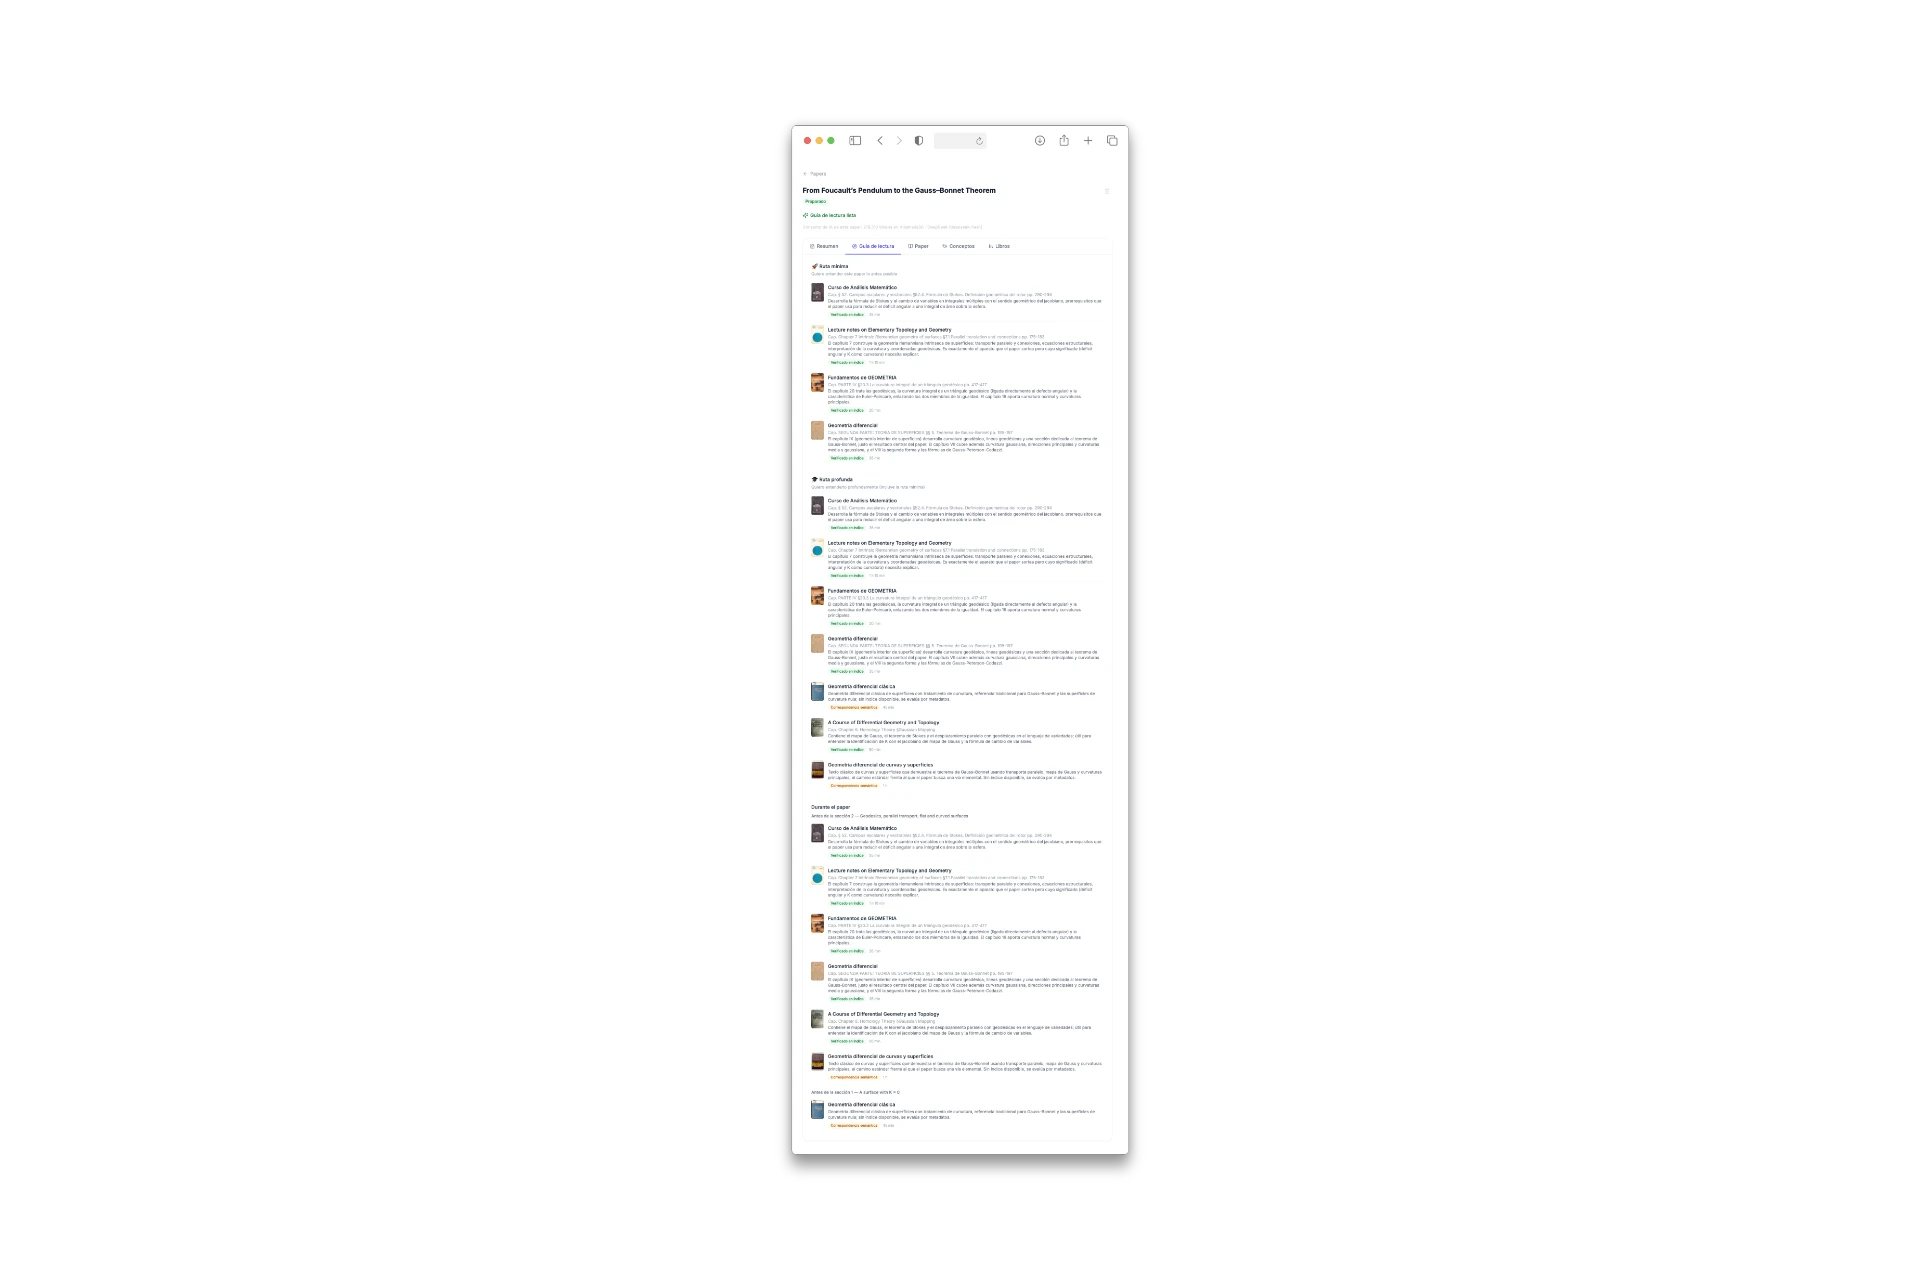
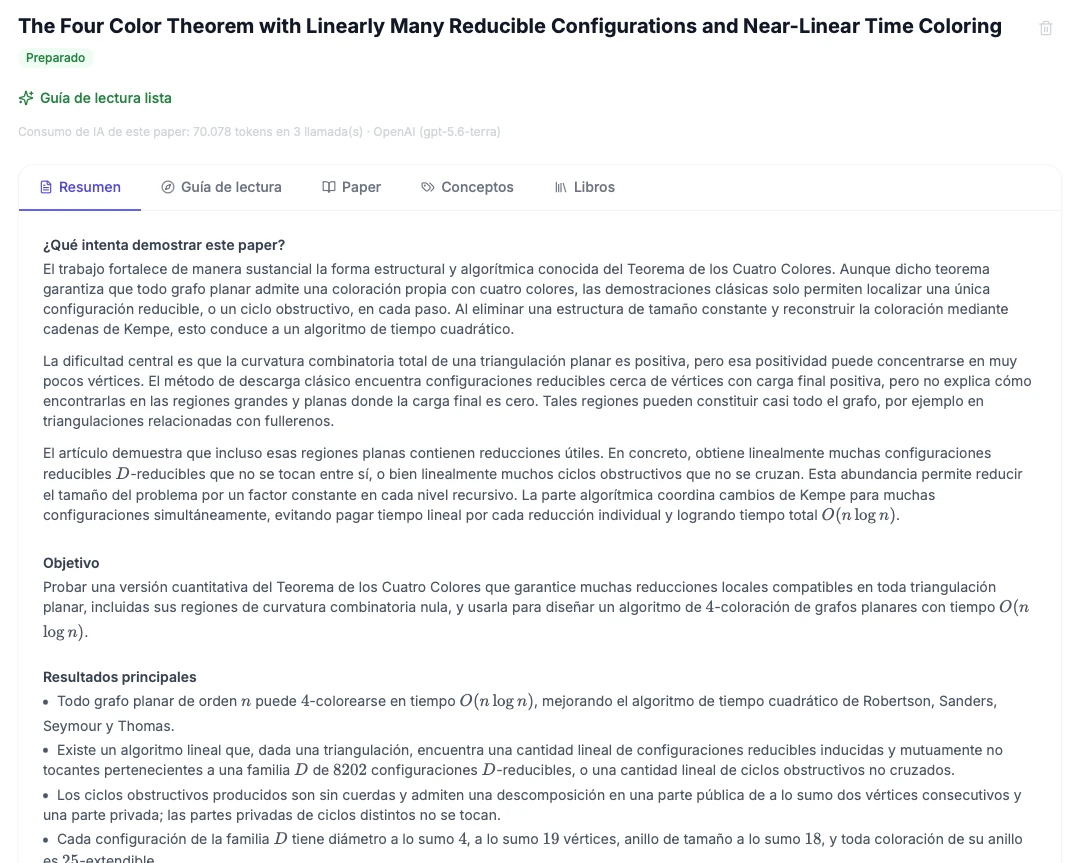
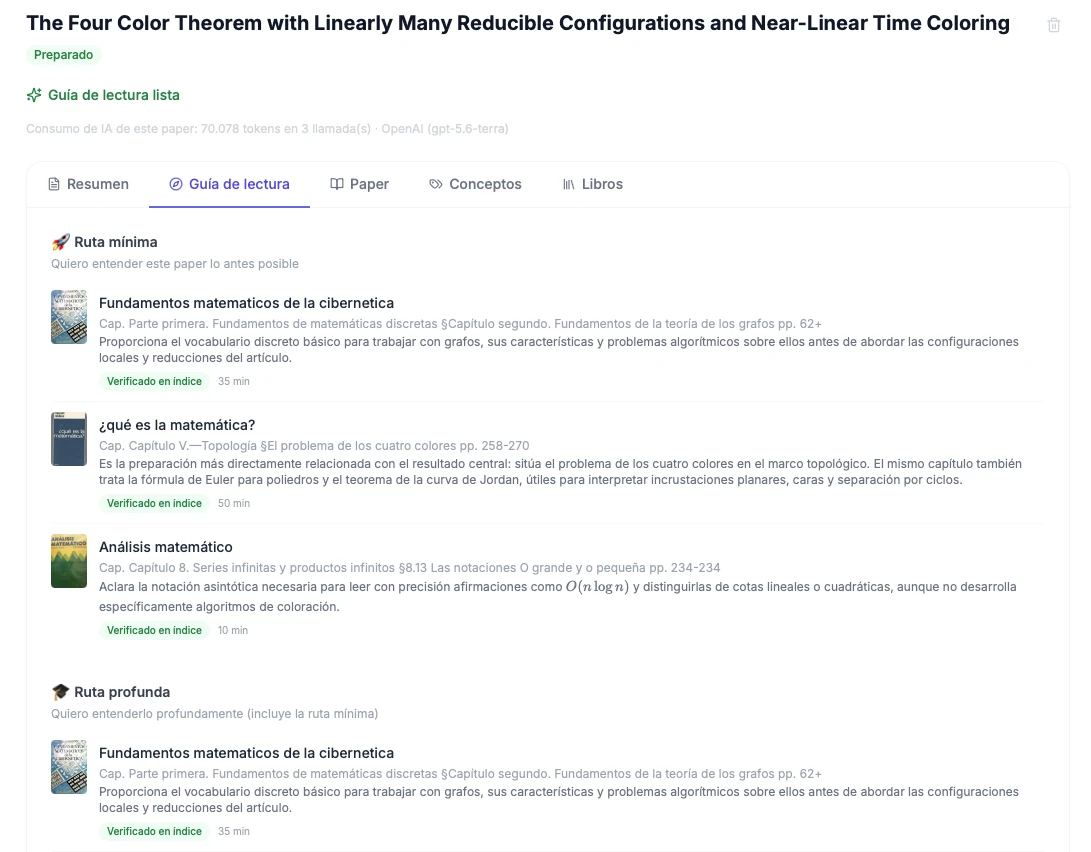
Los papers son una de las ultimas incorporaciones que mas me ha gustado y la mas gratificante. La matemática es un disciplina muy amplia y aunque tengas dominada un area determinada es muy probable que carezcas del conocimiento necesario en otra disciplina. Un método de aprendizaje que me gusta mucho es localizar papers interesantes sobre geometría o teoría de números y destriparlo de modo que pueda adquirir una base suficiente para comprender el paper por completo. El esquema y la aplicación contemplan artículos de investigación y sus secciones: extracción de conceptos, análisis, relación con la biblioteca y recomendaciones con distinto grado y tipo de evidencia.
Arquitectura del proyecto
El backend es Nodejs con React 18 y Tailwind CSS para los estilos. Recharts lo he usado par alas gráficas super-chulas. PDF.js es la librería encargada de previsualizar los libros en formato PDF (todavía hay que trabajarlo un poco porque en algunos navegadores y bajo ciertas circunstancias no se ve bien. Y en movilidad tampoco va fino). Katex es fundamental en una librería matematica donde los resúmenes, las notas y las descripciones incluyen formulas en prácticamente todos los casos. La bases de datos ahora es una PostgreSQL, debido al mal rendimiento de SQLite.
Las llamadas a la IA son mediante la API que exponen los diferentes proveedores y que además son configurables principalmente por un motivo económico y de optimización. Gemini hace muy bien el reconocimiento de texto en las carátulas de los libros y Deepseek por ejemplo genera unos resúmenes muy buenos. De todos modos las respuestas estructuradas se validan antes de guardar. No siempre se pasa la biblioteca entera a la IA ( ya se que hay algunas aproximaciones para que el modelo almacene en el contexto los libros pero no acabo de verlo), por lo que primero se intenta resolver con consultas a postgres (buscando texto, heurísticas, taxonomías y reglas locales). Solo se pasa a modelo lo que necesita interpretación. Posteriormente se validan las respuestas contra autores, categorías, temas y libros (y páginas) reales de la base de datos.
Finalmente la IA propone y yo confirmo
Las sugerencias de metadatos, categorías, notas o relaciones no afectan al catálogo hasta que se aplican o descartan. Lo mismo ocurre con las relaciones entre los libros que sugiere. También ocurre con los itinerarios en vista previa. Es la solución a un problema real (minimizar las alucinaciones). Se hacen listas cerradas. Se usan identificadores reales. Se hacen reintentos controlados. Se necesita confirmación humana. No se trata de que el modelo acierte. Es mas, absolutamente todas las llamadas a cualquier agente externo queda auditado y registrado el numero de tokens en cualquier sentido y por supuesto limitado.
En qué punto está
Como todo, está en desarrollo pero lo uso en mi día a día como si estuviera en producción. Me resuelve perfectamente mi propio problema.
Hay aspectos que todavía dependiendo de procesos por terminal y de revisiones manuales. Por ejemplo el proceso de clasificación de dominio y matemática. La carga masiva de clasificación requiere comandos administrativos y la lanzo yo manualmente, aunque no es necesario hacerlo con frecuencia pues es algo que rara vez cambia. Tengo en el roadmap la optimización para grandes cantidades de libros (scroll infinito, más índices, miniaturas, code-splitting), pero de momento no hay un problema de rendimiento con menos de 2.000 libros, tambien me apetece incluir una sección de wishlist y otra para las series de libros y tambien una nube de tags, pero como de momento la aplicación cumple su función a la perfección esto son solo ideas que siguen apuntadas en mi libreta.
Lo que el proyecto me sirve para explorar
Además de organizar mi biblioteca, la aplicación me permiteexperimentar con problemas muy interesantes: cómo combinar reglas locales con modelos de lenguaje ó cómo validar lo que devuelve una IA contra datos reales. LA extracción de estructuras directamente de los libros y la representación de las relaciones que hay entre libros categorías con todos sus requisitos previos. Cada una de esas partes sigue abierta, y por eso el proyecto continúa en desarrollo... y probablemente siempre lo estará ;)